Membangun portofolio data science merupakan salah satu langkah penting bagi siapa pun yang ingin memulai karier sebagai data analyst, data scientist, atau machine learning engineer. Portofolio tidak hanya berisi kumpulan kode Python, tetapi juga menunjukkan kemampuan seseorang dalam memahami data, menemukan pola, menguji hipotesis, membangun model, dan menyampaikan hasil analisis secara jelas. Kabar baiknya, pemula tidak harus memiliki data perusahaan sendiri atau mengeluarkan biaya besar untuk memulai proyek pertama.
Salah satu sumber data yang bisa dimanfaatkan adalah Kaggle. Platform ini menyediakan berbagai dataset, kompetisi machine learning, notebook, dan materi pembelajaran yang dapat digunakan untuk berlatih. Dengan memilih dataset yang sesuai, pemula dapat mengembangkan proyek yang terarah sekaligus mempelajari keterampilan yang banyak digunakan dalam pekerjaan berbasis data.
Ada banyak jenis proyek yang bisa dikerjakan, mulai dari memprediksi kelangsungan hidup penumpang Titanic, memperkirakan harga rumah, menganalisis pelanggan yang berhenti berlangganan, hingga mendeteksi transaksi kartu kredit yang berpotensi penipuan. Setiap proyek memiliki tujuan, karakteristik data, dan tingkat kesulitan yang berbeda. Karena itu, pemilihan proyek sebaiknya disesuaikan dengan kemampuan awal serta keterampilan yang ingin ditonjolkan.
1. Prediksi Kelangsungan Hidup Penumpang Titanic

Pengertian proyek Titanic: Machine Learning from Disaster
Proyek Titanic merupakan salah satu latihan machine learning yang populer bagi pemula karena memiliki tujuan yang mudah dipahami. Proyek ini menggunakan data penumpang kapal Titanic untuk membangun model yang memperkirakan apakah seorang penumpang selamat atau tidak berdasarkan karakteristik tertentu.
Dataset yang digunakan tersedia melalui kompetisi Titanic: Machine Learning from Disaster di Kaggle. Data latihan umumnya mencakup informasi seperti usia, jenis kelamin, kelas tiket, jumlah anggota keluarga, tarif tiket, dan pelabuhan keberangkatan.
Dalam proyek ini, variabel target bernama Survived menunjukkan hasil kelangsungan hidup penumpang. Nilai 1 berarti selamat, sedangkan nilai 0 berarti tidak selamat. Karena target hanya memiliki dua kemungkinan, permasalahan ini disebut klasifikasi biner (binary classification).
Tujuan dan keterampilan yang dipelajari
Tujuan utamanya bukan sekadar mendapatkan akurasi setinggi mungkin. Proyek ini juga membantu pemula memahami bagaimana data mentah diubah menjadi masukan yang dapat digunakan model prediksi.
Keterampilan yang bisa dikembangkan meliputi:
- Memahami struktur dataset menggunakan Pandas.
- Mengidentifikasi data kosong atau missing values.
- Melakukan eksplorasi data atau Exploratory Data Analysis (EDA).
- Membuat visualisasi menggunakan Matplotlib dan Seaborn.
- Mengubah data kategori menjadi format numerik.
- Melatih dan mengevaluasi model klasifikasi.
Sebagai contoh, analisis awal dapat digunakan untuk memeriksa apakah tingkat kelangsungan hidup berbeda menurut jenis kelamin atau kelas tiket. Temuan tersebut perlu dibuktikan melalui perhitungan dari dataset, bukan hanya berdasarkan dugaan.
Metode analisis yang direkomendasikan
Logistic Regression cocok digunakan sebagai model awal karena relatif mudah dipahami dan menghasilkan probabilitas untuk kelas target. Walaupun namanya mengandung kata regression, metode ini umum digunakan untuk klasifikasi.
Model pembandingnya adalah Decision Tree, yaitu algoritma yang membuat keputusan melalui serangkaian percabangan berdasarkan fitur tertentu. Pohon keputusan relatif mudah divisualisasikan sehingga pemula dapat mempelajari cara model menentukan prediksi.
Tahapan pengerjaannya dapat disusun sebagai berikut:
- Unduh dataset dari kompetisi Kaggle.
- Periksa tipe data, jumlah baris, dan nilai yang hilang.
- Lakukan EDA untuk memahami hubungan antara fitur dan target.
- Bersihkan data dan siapkan fitur kategorikal maupun numerik.
- Pisahkan data menjadi data latih dan data pengujian.
- Latih Logistic Regression dan Decision Tree.
- Bandingkan hasil menggunakan accuracy, precision, recall, F1-score, dan confusion matrix jika sesuai dengan tujuan evaluasi.
Perlu diperhatikan bahwa pemisahan data harus dilakukan dengan benar agar model tidak mempelajari informasi yang seharusnya hanya tersedia pada data pengujian.
Ide pengembangan portofolio
Agar proyek lebih menarik, buat laporan singkat yang menjelaskan fitur apa saja yang paling berhubungan dengan prediksi model. Sertakan pula perbandingan hasil kedua algoritma, alasan memilih metrik evaluasi, dan keterbatasan model.
Nilai portofolio: proyek ini sangat cocok untuk menunjukkan pemahaman dasar Python, EDA, preprocessing, dan klasifikasi machine learning.
2. Analisis Prediksi Harga Rumah dengan House Prices: Advanced Regression Techniques
Pengertian proyek prediksi harga rumah
Proyek prediksi harga rumah bertujuan membangun model yang dapat memperkirakan nilai jual properti berdasarkan karakteristik bangunan dan lokasinya. Berbeda dengan proyek Titanic yang menghasilkan kategori, proyek ini menghasilkan angka berupa estimasi harga.
Dataset yang digunakan adalah House Prices: Advanced Regression Techniques di Kaggle. Dataset tersebut menggunakan data properti di Ames, Iowa, Amerika Serikat, dengan berbagai informasi tentang luas bangunan, kondisi rumah, lingkungan, tahun pembangunan, garasi, dan fasilitas lainnya. Variabel target utamanya adalah SalePrice, yaitu harga jual rumah.
Permasalahan ini termasuk regresi kuantitatif (quantitative regression) karena model diminta memperkirakan nilai numerik, bukan memilih kelas tertentu.
Tujuan dan keterampilan yang dipelajari
Proyek ini sangat bermanfaat bagi pemula yang ingin memahami bagaimana karakteristik suatu objek dapat memengaruhi nilai yang diprediksi. Selain belajar membuat model, pengguna juga dapat mempelajari hubungan antara fitur numerik, fitur kategorikal, dan harga properti.
Keterampilan yang dapat dikembangkan antara lain:
- Membersihkan data numerik dan kategorikal.
- Menganalisis distribusi harga rumah.
- Memeriksa hubungan antara luas bangunan dan harga jual.
- Menangani nilai kosong secara tepat.
- Melakukan feature engineering.
- Membandingkan beberapa model regresi.
- Mengevaluasi kesalahan prediksi menggunakan metrik yang sesuai.
Salah satu hal menarik dari dataset ini adalah jumlah dan ragam fiturnya. Luas bangunan, kualitas material, kondisi rumah, serta lingkungan tempat tinggal dapat dianalisis sebagai variabel yang berpotensi berhubungan dengan harga. Namun, hubungan tersebut harus diuji melalui data dan tidak boleh langsung dianggap sebagai hubungan sebab-akibat.
Metode analisis yang direkomendasikan
Mulailah dengan Linear Regression sebagai model dasar. Model ini relatif mudah dipahami dan dapat digunakan sebagai pembanding sebelum mencoba algoritma yang lebih kompleks.
Setelah itu, coba XGBoost, yaitu algoritma gradient boosting berbasis pohon keputusan yang membangun model secara bertahap untuk memperbaiki kesalahan prediksi sebelumnya. XGBoost dapat menangkap pola nonlinier dan interaksi antarf fitur yang mungkin sulit dijelaskan oleh regresi linear sederhana.
Teknik feature engineering juga penting. Contohnya, beberapa kolom luas bangunan dapat digabungkan untuk membentuk fitur luas total, sedangkan umur rumah dapat dihitung dari tahun penjualan dikurangi tahun pembangunan. Pembuatan fitur baru harus mempertimbangkan makna bisnis dan ketersediaan informasi ketika prediksi dilakukan.
Tahapan pengerjaan proyek:
- Unduh
train.csv,test.csv, dandata_description.txt. - Pelajari arti setiap kolom melalui dokumentasi dataset.
- Analisis distribusi
SalePricedan periksa pencilan. - Tangani nilai kosong serta ubah variabel kategorikal menjadi representasi yang dapat diproses model.
- Buat fitur tambahan yang relevan.
- Latih model regresi dasar dan XGBoost.
- Bandingkan hasil menggunakan MAE, RMSE, atau RMSLE sesuai kebutuhan evaluasi.
Kompetisi Kaggle ini menggunakan Root Mean Squared Logarithmic Error (RMSLE) untuk menilai prediksi. Oleh karena itu, pemula sebaiknya mempelajari perbedaan metrik tersebut dengan MAE dan RMSE sebelum menyimpulkan bahwa satu model lebih baik daripada model lainnya.
Ide pengembangan portofolio
Buat grafik yang membandingkan harga aktual dengan harga prediksi. Tambahkan analisis fitur yang paling berpengaruh menurut model, serta contoh rumah yang memiliki kesalahan prediksi tinggi.
Nilai portofolio: proyek ini menunjukkan kemampuan regresi, pengolahan data tabular, feature engineering, dan evaluasi model prediksi numerik.
3. Analisis Prediksi Churn Pelanggan Telecom dengan Telco Customer Churn Dataset
Pengertian proyek churn pelanggan
Customer churn adalah kondisi ketika pelanggan berhenti menggunakan layanan atau mengakhiri hubungan berlangganannya dengan suatu perusahaan. Dalam industri telekomunikasi, churn bisa terjadi ketika pelanggan menghentikan layanan telepon atau internet, misalnya karena harga, kualitas layanan, kebutuhan yang berubah, atau penawaran pesaing.
Dataset Telco Customer Churn di Kaggle menyediakan informasi pelanggan, layanan yang digunakan, durasi berlangganan, jenis kontrak, metode pembayaran, biaya bulanan, dan status churn. Dataset ini dikaitkan dengan contoh data IBM untuk analisis retensi pelanggan.
Proyek ini menggabungkan analisis bisnis dan ilmu data. Pertanyaan utamanya bukan hanya siapa yang berpotensi berhenti berlangganan, tetapi juga karakteristik apa yang membedakan pelanggan yang bertahan dengan pelanggan yang pergi.
Tujuan dan keterampilan yang dipelajari
Melalui proyek ini, pemula dapat belajar menggunakan data untuk membantu perusahaan memahami retensi pelanggan. Retensi pelanggan berarti upaya mempertahankan pelanggan agar tetap menggunakan layanan dalam jangka waktu tertentu.
Beberapa pertanyaan yang dapat dijawab melalui analisis meliputi:
- Apakah tingkat churn berbeda menurut jenis kontrak?
- Bagaimana hubungan biaya bulanan dengan churn?
- Apakah pelanggan baru menunjukkan pola berbeda dari pelanggan lama?
- Layanan tambahan apa yang digunakan oleh kelompok pelanggan tertentu?
- Bagaimana perusahaan dapat menyusun program retensi yang lebih tepat sasaran?
Pertanyaan tersebut perlu dijawab dengan statistik dan visualisasi dari dataset, bukan asumsi. Perbedaan yang terlihat juga belum tentu menunjukkan penyebab churn.
Metode analisis yang direkomendasikan
Mulailah dengan Exploratory Data Analysis (EDA) menggunakan Pandas, Seaborn, dan Plotly. EDA merupakan proses memahami data melalui statistik ringkas, distribusi, perbandingan kelompok, serta visualisasi sebelum membuat model.
Gunakan grafik batang untuk membandingkan tingkat churn menurut jenis kontrak atau metode pembayaran. Histogram dapat membantu memahami distribusi biaya bulanan, sedangkan boxplot dapat digunakan untuk membandingkan distribusi biaya antara pelanggan yang bertahan dan yang berhenti.
Jika ingin melanjutkan ke machine learning, gunakan Logistic Regression atau Decision Tree untuk memprediksi churn. Evaluasi model menggunakan precision, recall, F1-score, dan confusion matrix. Dalam konteks retensi, recall untuk kelas churn bisa menjadi perhatian karena perusahaan mungkin ingin mengidentifikasi sebanyak mungkin pelanggan yang benar-benar berisiko pergi.
Tahapan pengerjaannya:
- Periksa struktur kolom, tipe data, nilai kosong, dan duplikasi.
- Pastikan kolom biaya yang seharusnya numerik tidak terbaca sebagai teks.
- Analisis proporsi pelanggan yang churn dan bertahan.
- Bandingkan churn berdasarkan kontrak, masa berlangganan, dan biaya.
- Buat dashboard ringkas menggunakan Plotly atau alat visualisasi lain.
- Jika diperlukan, latih model klasifikasi.
- Susun rekomendasi retensi berdasarkan hasil analisis.
Ide pengembangan portofolio
Buat dashboard yang menampilkan tingkat churn, jumlah pelanggan, distribusi biaya, dan karakteristik pelanggan berisiko. Sertakan catatan bahwa hasil model hanya membantu penentuan prioritas, bukan memastikan seseorang akan berhenti berlangganan.
Nilai portofolio: proyek ini cocok untuk menunjukkan keterampilan EDA, visualisasi interaktif, analisis bisnis, dan klasifikasi pelanggan.
4. Analisis Sentimen Ulasan Film IMDb dengan Natural Language Processing
Pengertian proyek analisis sentimen
Analisis sentimen merupakan proses mengidentifikasi kecenderungan opini dalam teks, misalnya positif atau negatif. Teknik ini termasuk bagian dari Natural Language Processing (NLP), yaitu bidang yang mempelajari bagaimana komputer mengolah dan menganalisis bahasa manusia.
Untuk proyek pemula, gunakan IMDb Movie Reviews Dataset di Kaggle, yang berisi ulasan film dan label sentimen. Dataset ini umum digunakan untuk mempelajari klasifikasi teks.
Tujuan proyek adalah melatih model agar dapat memprediksi apakah sebuah ulasan mengandung sentimen positif atau negatif. Misalnya, ulasan yang menyebut cerita menarik dan akting bagus mungkin menunjukkan sentimen positif, sedangkan ulasan yang menyebut alur membosankan dapat menunjukkan sentimen negatif. Contoh tersebut hanya ilustrasi; penilaian sebenarnya bergantung pada keseluruhan konteks teks.
Tujuan dan keterampilan yang dipelajari
Data teks memiliki tantangan berbeda dari data tabular. Kalimat yang memiliki makna serupa dapat menggunakan kosakata berbeda, sedangkan kata yang sama bisa memiliki makna berbeda bergantung pada konteks.
Melalui proyek ini, pemula akan mempelajari:
- Membaca dan membersihkan data teks.
- Memahami tokenisasi.
- Mengubah teks menjadi fitur numerik.
- Melatih model klasifikasi teks.
- Mengevaluasi kesalahan prediksi.
- Menganalisis kata atau pola bahasa yang berkaitan dengan sentimen.
Salah satu tantangan yang menarik adalah negasi. Kalimat seperti “film ini tidak buruk” tidak selalu memiliki sentimen negatif, meskipun mengandung kata “buruk”. Karena itu, pembersihan teks harus dilakukan secara hati-hati agar informasi penting tidak hilang.
Metode analisis yang direkomendasikan
Gunakan TF-IDF (Term Frequency–Inverse Document Frequency) untuk mengubah teks menjadi representasi numerik. Metode ini memberikan bobot berdasarkan frekuensi kata dalam suatu dokumen dan seberapa umum kata tersebut di seluruh kumpulan dokumen.
Setelah itu, gunakan Multinomial Naive Bayes sebagai model awal. Algoritma ini relatif sederhana, cepat, dan sering dijadikan baseline untuk klasifikasi teks berbasis frekuensi kata.
Tahapan proyek:
- Unduh dataset dan periksa distribusi label sentimen.
- Periksa teks kosong, duplikasi, dan kualitas label.
- Pisahkan data latih dan data pengujian.
- Buat pipeline TF-IDF dan Naive Bayes.
- Latih model menggunakan data latih.
- Evaluasi precision, recall, F1-score, dan confusion matrix.
- Periksa contoh prediksi yang salah untuk memahami kelemahan model.
Penting: proses pembentukan kosakata TF-IDF harus dipelajari hanya dari data latih. Jika seluruh data digunakan sebelum pemisahan, informasi dari data pengujian dapat bocor ke proses pelatihan dan membuat evaluasi kurang dapat dipercaya.
Ide pengembangan portofolio
Buat aplikasi sederhana yang menerima teks ulasan film dan menampilkan prediksi sentimen beserta probabilitas atau skor model yang relevan. Tambahkan beberapa contoh kesalahan prediksi, terutama ulasan sarkastis atau kalimat dengan negasi.
Nilai portofolio: proyek ini menunjukkan pemahaman NLP dasar, representasi teks, pipeline machine learning, dan evaluasi klasifikasi.
5. Deteksi Transaksi Kartu Kredit Palsu dengan Credit Card Fraud Detection Dataset
Pengertian proyek deteksi penipuan transaksi
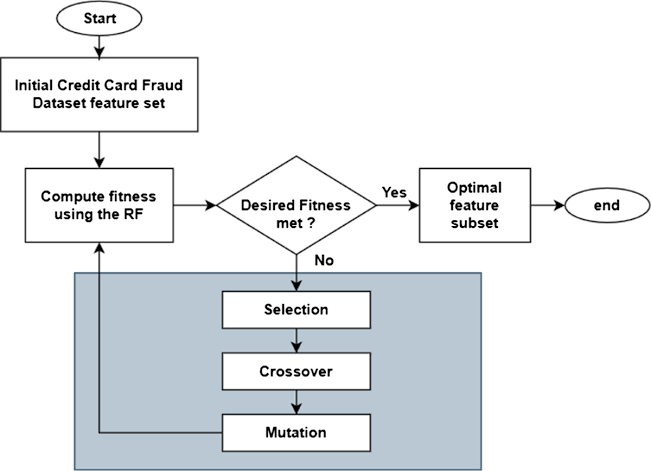
Credit card fraud detection adalah proses mengidentifikasi transaksi yang diduga dilakukan secara tidak sah. Dalam ilmu data, masalah ini sering dimodelkan sebagai klasifikasi biner: transaksi normal dan transaksi yang terindikasi penipuan.
Dataset Credit Card Fraud Detection di Kaggle merupakan salah satu dataset latihan yang populer untuk mempelajari masalah tersebut. Data ini berasal dari transaksi kartu kredit yang dilakukan oleh pemegang kartu di Eropa selama dua hari pada September 2013. Dataset memiliki ketidakseimbangan kelas yang sangat besar: transaksi penipuan hanya merupakan sebagian kecil dari keseluruhan transaksi.
Karakteristik ini membuat proyek lebih menantang daripada klasifikasi biasa. Model yang selalu memprediksi semua transaksi sebagai normal bisa mendapatkan akurasi yang terlihat tinggi, tetapi gagal menemukan transaksi penipuan.
Tujuan dan keterampilan yang dipelajari
Proyek ini membantu pemula memahami imbalanced data, yaitu kondisi ketika jumlah observasi pada suatu kelas jauh lebih banyak daripada kelas lainnya.
Keterampilan yang dapat dipelajari meliputi:
- Memeriksa distribusi kelas target.
- Mengidentifikasi karakteristik transaksi.
- Memahami perbedaan precision dan recall.
- Menguji teknik penanganan ketidakseimbangan data.
- Mengevaluasi model pada kasus yang jarang terjadi.
- Menghindari kebocoran data dalam pipeline machine learning.
Dataset ini memiliki fitur yang telah ditransformasikan, sehingga tidak semua kolom dapat ditafsirkan sebagai atribut transaksi yang mudah dipahami. Pemula sebaiknya membaca deskripsi dataset dan tidak mengarang arti bisnis dari fitur yang tidak dijelaskan.
Metode analisis yang direkomendasikan
Mulailah dengan Logistic Regression atau model pohon sebagai baseline. Kemudian, bandingkan hasilnya dengan pendekatan penanganan ketidakseimbangan kelas.
Salah satu teknik yang dapat dipelajari adalah SMOTE (Synthetic Minority Over-sampling Technique). Teknik ini membuat sampel sintetis untuk kelas minoritas berdasarkan hubungan dengan sampel minoritas lain. SMOTE tidak sekadar menduplikasi setiap transaksi penipuan, tetapi menghasilkan titik data baru melalui interpolasi.
Namun, SMOTE tidak selalu meningkatkan hasil. Data sintetis juga dapat membuat batas kelas menjadi kurang tepat jika diterapkan tanpa evaluasi yang cermat.
Urutan pengerjaan yang disarankan:
- Periksa jumlah transaksi normal dan penipuan.
- Pisahkan data menjadi data latih dan pengujian dengan mempertimbangkan proporsi kelas.
- Buat baseline tanpa oversampling.
- Terapkan SMOTE hanya pada data latih atau di dalam pipeline validasi.
- Bandingkan model dengan dan tanpa SMOTE.
- Evaluasi precision, recall, F1-score, PR-AUC, serta confusion matrix.
- Analisis dampak false positive dan false negative.
Dalam konteks ini, false positive berarti transaksi normal ditandai sebagai penipuan, sedangkan false negative berarti transaksi penipuan tidak terdeteksi. Keduanya menimbulkan konsekuensi yang berbeda.
Ide pengembangan portofolio
Tampilkan perbandingan hasil model dalam tabel dan grafik precision-recall. Jelaskan bahwa model deteksi penipuan harus dievaluasi berdasarkan risiko dan biaya kesalahan, bukan hanya akurasi.
Nilai portofolio: proyek ini memperlihatkan kemampuan menangani kelas tidak seimbang, memilih metrik evaluasi yang tepat, dan memahami risiko prediksi.
6. Segmentasi Pasar dan Pelanggan Mall dengan K-Means Clustering
Pengertian proyek segmentasi pelanggan
Segmentasi pelanggan adalah proses mengelompokkan pelanggan berdasarkan karakteristik atau perilaku yang memiliki kemiripan. Dalam dunia bisnis, segmentasi dapat membantu perusahaan memahami bahwa pelanggan tidak selalu memiliki kebutuhan, daya beli, dan kebiasaan belanja yang sama.
Dataset yang digunakan adalah Mall Customer Segmentation Data di Kaggle. Dataset versi pembelajaran yang umum digunakan memuat sekitar 200 catatan pelanggan dengan lima kolom utama, yaitu ID pelanggan, jenis kelamin, usia, pendapatan tahunan, dan spending score. Versi dataset yang diunduh sebaiknya tetap diperiksa karena nama kolom atau sumber unggahan dapat berbeda.
Spending score adalah skor pengeluaran yang tersedia di dataset, bukan jumlah uang yang benar-benar dibelanjakan dalam satuan mata uang. Karena itu, skor tersebut perlu dipahami berdasarkan deskripsi dataset, bukan dianggap sebagai nominal transaksi aktual.
Berbeda dengan proyek Titanic dan prediksi harga rumah, segmentasi pelanggan tidak harus memiliki kolom target yang berisi jawaban benar. Proyek ini termasuk unsupervised learning, yaitu pembelajaran mesin yang mencari struktur atau pola dalam data tanpa label target yang telah ditentukan.
Tujuan dan keterampilan yang dipelajari
Tujuan proyek adalah menemukan kelompok pelanggan dengan karakteristik yang mirip, kemudian menjelaskan apa arti kelompok tersebut bagi kebutuhan analisis bisnis.
Sebagai contoh, hasil pengelompokan mungkin menunjukkan kelompok pelanggan dengan pendapatan tinggi dan skor pengeluaran tinggi, atau kelompok dengan pendapatan tinggi tetapi skor pengeluaran relatif rendah. Kelompok tersebut dapat menjadi bahan untuk merancang hipotesis strategi pemasaran, tetapi tidak otomatis membuktikan bahwa pelanggan tertentu akan merespons suatu promosi.
Keterampilan yang bisa dipelajari meliputi:
- EDA menggunakan Pandas dan Seaborn.
- Pemilihan fitur untuk clustering.
- Standardisasi fitur numerik.
- Penerapan algoritma K-Means.
- Pemilihan jumlah cluster.
- Visualisasi dan interpretasi kelompok pelanggan.
Metode analisis yang direkomendasikan
Algoritma utama yang direkomendasikan adalah K-Means Clustering. Algoritma ini membagi data menjadi sejumlah kelompok berdasarkan jarak setiap titik data terhadap pusat kelompok atau centroid.
Jumlah kelompok harus ditentukan sebelum model K-Means dijalankan. Pemula dapat membandingkan beberapa nilai \(k\) dengan metode Elbow dan Silhouette Score.
Metode Elbow memeriksa bagaimana total variasi dalam cluster berkurang ketika jumlah cluster bertambah. Sementara itu, Silhouette Score menilai seberapa dekat suatu titik dengan kelompoknya sendiri dibandingkan dengan kelompok lain. Kedua metode membantu proses pemilihan jumlah cluster, tetapi tidak selalu menghasilkan satu jawaban yang pasti benar.
Langkah pengerjaannya:
- Unduh dataset dan pahami arti setiap kolom.
- Periksa distribusi usia, pendapatan, dan spending score.
- Pilih fitur yang relevan dengan tujuan segmentasi.
- Lakukan standardisasi jika diperlukan, terutama ketika skala fitur berbeda.
- Jalankan K-Means dengan beberapa pilihan nilai \(k\).
- Bandingkan hasil menggunakan Elbow Method dan Silhouette Score.
- Buat visualisasi cluster dan analisis karakteristik setiap kelompok.
ID pelanggan umumnya tidak perlu dijadikan fitur clustering karena berfungsi sebagai identitas, bukan ukuran perilaku pelanggan.
Ide pengembangan portofolio
Buat scatter plot yang menampilkan pendapatan tahunan dan spending score dengan warna berbeda untuk setiap cluster. Setelah itu, susun tabel profil cluster yang memuat rata-rata usia, pendapatan, dan skor pengeluaran.
Tambahkan interpretasi sederhana, misalnya kelompok yang berpotensi menjadi sasaran program loyalitas atau kelompok yang mungkin memerlukan pendekatan promosi berbeda. Gunakan istilah potensi dan hipotesis pemasaran, bukan klaim bahwa segmentasi sudah terbukti meningkatkan penjualan.
Nilai portofolio: proyek ini cocok untuk pemula yang ingin mempelajari unsupervised learning, visualisasi, dan penerjemahan hasil analisis menjadi wawasan bisnis.
7. Klasifikasi Gambar Digit Tulisan Tangan dengan MNIST
Pengertian proyek klasifikasi digit tulisan tangan
MNIST adalah singkatan dari Modified National Institute of Standards and Technology. Dataset ini berisi gambar digit tulisan tangan dari angka 0 sampai 9 yang telah disiapkan untuk penelitian dan pembelajaran pengenalan pola.
Dalam versi MNIST klasik, dataset memiliki 70.000 gambar grayscale berukuran 28 × 28 piksel, yang terdiri atas 60.000 gambar untuk pelatihan dan 10.000 gambar untuk pengujian. Dataset tersebut juga tersedia melalui berbagai repositori pembelajaran dan versi Kaggle, termasuk Digit Recognizer di Kaggle.
Tujuan proyek adalah membangun model yang dapat mengenali angka pada gambar. Misalnya, ketika diberikan gambar tulisan tangan angka 7, model diharapkan memprediksi kelas 7.
Proyek ini memperkenalkan pemula pada computer vision, yaitu bidang yang mempelajari bagaimana komputer memproses dan memahami informasi visual.
Tujuan dan keterampilan yang dipelajari
Gambar berbeda dari tabel karena informasi utamanya tersimpan dalam susunan piksel. Setiap gambar MNIST berukuran 28 × 28 memiliki 784 nilai piksel jika diratakan menjadi satu vektor.
Melalui proyek ini, pemula dapat mempelajari:
- Memuat dataset gambar.
- Memahami bentuk dan nilai piksel.
- Melakukan normalisasi data.
- Membuat model klasifikasi gambar.
- Melatih model neural network.
- Memvisualisasikan hasil prediksi dan kesalahan model.
Salah satu tantangan utamanya adalah angka yang berbeda dapat memiliki bentuk tulisan tangan yang mirip. Angka 3 dan 5, misalnya, dapat terlihat serupa pada tulisan tertentu. Karena itu, evaluasi tidak cukup hanya menggunakan satu contoh gambar.
Metode analisis yang direkomendasikan
Sebagai langkah awal, gunakan model sederhana seperti Logistic Regression atau multilayer perceptron untuk membangun baseline. Setelah memahami proses klasifikasi gambar, lanjutkan dengan Convolutional Neural Network (CNN).
CNN adalah jenis jaringan saraf yang dirancang untuk mempelajari pola spasial dalam data, termasuk gambar. Lapisan konvolusi dapat mengenali pola lokal seperti garis, lengkungan, dan bagian bentuk angka, sedangkan lapisan berikutnya menggabungkan informasi tersebut untuk menghasilkan prediksi kelas.
Tahapan pengerjaan proyek:
- Unduh atau muat dataset MNIST.
- Tampilkan beberapa contoh gambar beserta labelnya.
- Periksa distribusi kelas angka 0–9.
- Normalisasi nilai piksel, misalnya ke rentang 0–1.
- Siapkan data pelatihan dan pengujian dengan benar.
- Latih baseline sederhana, kemudian bangun CNN.
- Evaluasi hasil dengan accuracy, confusion matrix, dan contoh prediksi yang salah.
Jika menggunakan data pengujian resmi, jangan menggunakannya untuk memilih konfigurasi model berulang kali. Untuk penyetelan parameter, sisihkan sebagian data latih sebagai data validasi.
Ide pengembangan portofolio
Buat aplikasi kecil yang memungkinkan pengguna mengunggah gambar atau menggambar angka pada kanvas, kemudian menampilkan hasil prediksi model. Tambahkan confidence score jika model mendukung keluaran probabilitas, dengan penjelasan bahwa skor tersebut tidak selalu sama dengan tingkat kepastian yang terkalibrasi.
Nilai portofolio: proyek ini dapat menunjukkan kemampuan dasar computer vision, deep learning, preprocessing gambar, dan pembangunan aplikasi demonstrasi machine learning.
8. Analisis Tren Penjualan E-Commerce dengan Brazilian E-Commerce Public Dataset by Olist
Pengertian proyek analisis data e-commerce
Analisis tren penjualan e-commerce adalah proses mempelajari data transaksi untuk memahami perkembangan pesanan, nilai penjualan, pola pembelian, performa pengiriman, serta pengalaman pelanggan. Hasilnya dapat digunakan untuk membantu menjawab pertanyaan bisnis seperti kategori produk apa yang banyak terjual, kapan pesanan meningkat, atau bagaimana keterlambatan pengiriman berhubungan dengan ulasan pelanggan.
Dataset yang digunakan adalah Brazilian E-Commerce Public Dataset by Olist di Kaggle. Dataset ini memuat informasi sekitar 100.000 pesanan dari tahun 2016 hingga 2018, termasuk informasi pelanggan, pesanan, produk, penjual, pembayaran, pengiriman, dan ulasan. Data dibagi ke dalam beberapa file yang saling berhubungan.
Dataset ini lebih kompleks daripada dataset sebelumnya karena analisisnya membutuhkan penggabungan beberapa tabel. Di sinilah pemula dapat menunjukkan bahwa kemampuan data science tidak hanya berkaitan dengan algoritma machine learning, tetapi juga dengan pengelolaan dan pemahaman data bisnis.
Tujuan dan keterampilan yang dipelajari
Proyek ini cocok bagi pemula yang ingin membangun portofolio data analyst sekaligus mempelajari fondasi data science. Tujuan awalnya adalah mengubah data transaksi menjadi informasi yang dapat dipahami oleh orang nonteknis.
Beberapa pertanyaan analisis yang dapat digunakan antara lain:
- Bagaimana jumlah pesanan berubah dari bulan ke bulan?
- Kategori produk apa yang menyumbang nilai transaksi terbesar?
- Bagaimana distribusi metode pembayaran?
- Bagaimana perbedaan waktu pengiriman antara estimasi dan realisasi?
- Apakah pesanan yang terlambat memiliki pola ulasan berbeda?
- Bagaimana karakteristik pelanggan yang melakukan pembelian berulang?
Pertanyaan tersebut harus disesuaikan dengan kolom dan rentang data yang tersedia. Periode dataset berakhir pada 2018, sehingga hasilnya tidak boleh dipresentasikan sebagai gambaran kondisi pasar e-commerce Brasil saat ini.
Metode analisis yang direkomendasikan
Mulailah dengan Exploratory Data Analysis (EDA) komprehensif menggunakan Pandas dan visualisasi. Setelah memahami struktur datanya, gunakan SQL untuk melakukan agregasi, menggabungkan tabel, serta menghitung indikator bisnis.
SQL (Structured Query Language) adalah bahasa yang digunakan untuk mengelola dan mengambil data dari basis data relasional. Dalam proyek ini, SQL dapat membantu menghitung jumlah pesanan per bulan, nilai pembayaran, atau ringkasan performa penjual tanpa harus melakukan seluruh analisis secara manual.
Tahapan pengerjaan yang direkomendasikan:
- Unduh dataset dan pelajari dokumentasi setiap file.
- Periksa kunci penghubung antartabel, seperti ID pesanan dan ID pelanggan.
- Tentukan definisi indikator bisnis sebelum menghitungnya.
- Bersihkan data dan periksa nilai kosong serta duplikasi.
- Gunakan SQL atau Pandas untuk menggabungkan tabel yang relevan.
- Analisis tren bulanan, kategori produk, pembayaran, dan pengiriman.
- Buat dashboard untuk menampilkan hasil analisis.
- Tulis rekomendasi bisnis berdasarkan temuan yang benar-benar didukung data.
Ada hal penting dalam penghitungan penjualan: jumlah pesanan tidak sama dengan jumlah item, dan jumlah pembayaran tidak selalu sama dengan nilai penjualan bersih. Satu pesanan dapat berisi beberapa item dan memiliki beberapa catatan pembayaran. Karena itu, penggabungan tabel tanpa memahami relasi datanya dapat menggandakan nilai transaksi dan menghasilkan kesimpulan yang keliru.
Untuk mengukur performa pengiriman, misalnya, tentukan terlebih dahulu bagaimana pesanan yang dibatalkan atau belum terkirim akan diperlakukan. Untuk analisis ulasan, pastikan pula bahwa ulasan yang tidak tersedia tidak otomatis dianggap sebagai ulasan negatif.
Ide pengembangan portofolio
Buat dashboard yang memuat tren jumlah pesanan bulanan, kategori produk, distribusi pembayaran, dan ketepatan pengiriman. Tambahkan bagian metodologi singkat yang menjelaskan definisi setiap metrik dan cara menangani data yang tidak lengkap.
Jika ingin meningkatkan kompleksitas, lanjutkan dengan analisis pelanggan berulang menggunakan ID pelanggan unik, atau eksplorasi hubungan antara waktu pengiriman dan skor ulasan. Hubungan statistik tersebut dapat menjadi bahan penyelidikan lebih lanjut, bukan bukti otomatis bahwa keterlambatan menyebabkan ulasan buruk.
Nilai portofolio: proyek ini sangat baik untuk menunjukkan kemampuan SQL, EDA, data wrangling, analisis bisnis, dan pembuatan dashboard berdasarkan data dari beberapa tabel.
Cara Memilih Proyek Data Science yang Tepat untuk Portofolio Pemula
Delapan proyek di atas tidak harus dikerjakan sekaligus. Pemula justru lebih baik memilih satu proyek, menyelesaikannya sampai tuntas, lalu melanjutkan ke proyek lain setelah memahami proses analisisnya.
Agar pemilihan lebih mudah, pertimbangkan tiga hal berikut.
1. Sesuaikan proyek dengan keterampilan yang ingin ditonjolkan
Jika ingin melamar sebagai data analyst, prioritaskan proyek yang menampilkan kemampuan membersihkan data, SQL, visualisasi, dan menyampaikan temuan bisnis. Analisis churn pelanggan dan data e-commerce Olist bisa menjadi pilihan yang relevan.
Jika ingin memulai karier sebagai data scientist, proyek Titanic dan prediksi harga rumah dapat digunakan untuk mempelajari alur machine learning dari awal. Setelah itu, lanjutkan ke analisis sentimen atau deteksi penipuan untuk mempelajari karakteristik permasalahan yang berbeda.
Sementara itu, proyek MNIST cocok bagi pemula yang ingin mengeksplorasi deep learning dan computer vision.
2. Mulai dari model sederhana sebelum mencoba algoritma kompleks
Tidak perlu langsung menggunakan algoritma yang paling canggih. Model baseline merupakan model pembanding awal yang membantu menilai apakah pendekatan yang lebih kompleks benar-benar memberikan peningkatan.
Contohnya, gunakan Logistic Regression sebelum mencoba model klasifikasi yang lebih kompleks. Untuk prediksi harga rumah, bandingkan regresi linear dengan XGBoost. Untuk MNIST, mulailah dengan model sederhana sebelum menggunakan CNN.
Pendekatan tersebut membuat proses belajar lebih terarah karena setiap peningkatan dapat dibandingkan dengan hasil sebelumnya.
3. Dokumentasikan proses, bukan hanya hasil akhir
Portofolio yang baik tidak harus selalu memiliki akurasi tertinggi. Perekrut atau calon klien juga perlu memahami bagaimana kamu menyelesaikan masalah, alasan memilih metode tertentu, serta keterbatasan hasil analisis.
Setiap proyek sebaiknya memiliki:
- Deskripsi masalah: persoalan yang ingin diselesaikan.
- Sumber dan pemahaman data: asal dataset, struktur, dan batasannya.
- Tahapan pengolahan: pembersihan, transformasi, dan pemilihan fitur.
- Metode analisis: alasan menggunakan algoritma atau teknik tertentu.
- Evaluasi: metrik dan hasil pengujian yang relevan.
- Visualisasi: grafik yang membantu menjelaskan temuan.
- Kesimpulan praktis: manfaat, keterbatasan, dan pengembangan berikutnya.
Simpan kode dan dokumentasi di repositori GitHub yang rapi. Jika memungkinkan, tambahkan notebook yang dapat dijalankan ulang, README.md, serta petunjuk instalasi dependensi. Pastikan pula lisensi dataset mengizinkan penggunaan yang direncanakan dan jangan mengunggah data pribadi atau informasi rahasia.
Perbandingan 8 Proyek Data Science untuk Portofolio Pemula
Tabel berikut merangkum delapan proyek berdasarkan jenis masalah, teknik utama, dan keterampilan yang dapat ditunjukkan. Tingkat kesulitan merupakan perkiraan relatif untuk pemula, bukan penilaian resmi dari Kaggle.
| No. | Proyek dan dataset | Jenis analisis | Teknik utama | Tingkat kesulitan |
|---|---|---|---|---|
| 1 | Titanic | Klasifikasi biner | Logistic Regression, Decision Tree | Mudah |
| 2 | House Prices | Prediksi harga numerik | Regression, Feature Engineering, XGBoost | Menengah |
| 3 | Telco Customer Churn | Analisis retensi dan klasifikasi | EDA, Seaborn, Plotly | Mudah–menengah |
| 4 | IMDb Movie Reviews | Klasifikasi teks | NLP, TF-IDF, Naive Bayes | Menengah |
| 5 | Credit Card Fraud Detection | Deteksi anomali penipuan melalui klasifikasi | Imbalanced Data, SMOTE | Menengah–lanjutan |
| 6 | Mall Customer Segmentation | Segmentasi pelanggan | Unsupervised Learning, K-Means | Mudah–menengah |
| 7 | MNIST Digit Recognizer | Klasifikasi gambar | Computer Vision, CNN | Menengah–lanjutan |
| 8 | Brazilian E-Commerce Olist | Analisis transaksi dan tren bisnis | EDA, SQL, Data Visualization | Menengah |
Perlu diperhatikan bahwa tingkat kesulitan dapat berubah sesuai ruang lingkup pengerjaan. Proyek Titanic dengan model dasar relatif mudah, tetapi dapat menjadi lebih kompleks jika ditambah rekayasa fitur dan eksperimen model. Hal serupa berlaku untuk proyek MNIST: menjalankan model sederhana berbeda tingkat kesulitannya dengan membangun dan mengoptimalkan CNN.
Rekomendasi urutan belajar
Tahap 1 — Fondasi analisis data
Mulai dari Titanic atau Telco Customer Churn. Fokus pada Pandas, pembersihan data, EDA, dan visualisasi.
Tahap 2 — Analisis bisnis dan prediksi
Lanjutkan ke House Prices dan Olist untuk melatih regresi, feature engineering, SQL, serta penyusunan laporan bisnis.
Tahap 3 — Spesialisasi machine learning
Pilih IMDb untuk NLP, Credit Card Fraud untuk data tidak seimbang, Mall Customers untuk clustering, atau MNIST untuk computer vision.
Referensi Dataset dan Dokumentasi
Untuk menjaga kualitas portofolio, gunakan halaman dataset dan dokumentasi sebagai rujukan utama, bukan hanya menyalin notebook milik pengguna lain. Beberapa sumber yang relevan adalah:
- Kaggle Titanic Competition — deskripsi data dan aturan kompetisi.
- Kaggle House Prices — deskripsi kolom dan evaluasi.
- Telco Customer Churn — dataset dan deskripsi atribut pelanggan.
- Brazilian E-Commerce Public Dataset by Olist — dataset dan dokumentasi tabel.
- Mall Customer Segmentation — contoh penerapan K-Means.
Untuk dataset IMDb, Credit Card Fraud, dan MNIST, pelajari juga dokumentasi pustaka yang digunakan, khususnya scikit-learn dan TensorFlow atau Keras jika memilih CNN. Dokumentasi teknis membantu memastikan implementasi, evaluasi, dan penanganan data dilakukan sesuai praktik yang benar.
Pada akhirnya, proyek data science yang paling berguna untuk portofolio pemula bukanlah proyek yang paling rumit, melainkan proyek yang diselesaikan dengan baik dan dapat dijelaskan secara logis. Mulailah dengan satu dataset, pahami permasalahannya, dokumentasikan setiap keputusan, dan tunjukkan apa yang benar-benar dipelajari dari data. Setelah itu, tambahkan proyek lain untuk memperlihatkan perkembangan kemampuan secara bertahap.